3週間前に「Google Flowで8カットのAIショートを作った記録」という記事を書きました。8秒×8カット、64秒、縦9:16、Veo 3.1 Fast、消費クレジット160。
今回もまったく同じスペックで作りました。題材だけ変えて、親指サイズの子犬シェフが超巨大なスフレパンケーキを焼いて空中で回す話です。
そして主人公の子犬が、カットごとに別の犬種になりました。
前回と違うことを1つだけやったせいでした。その1つが何だったか、そしてなぜ前回の記事に書いた結論と今回の結論が逆に見えるのか。整理できたので残しておきます。
何が起きたか
繋いだあと、各カットの中間フレームを1枚に並べました。
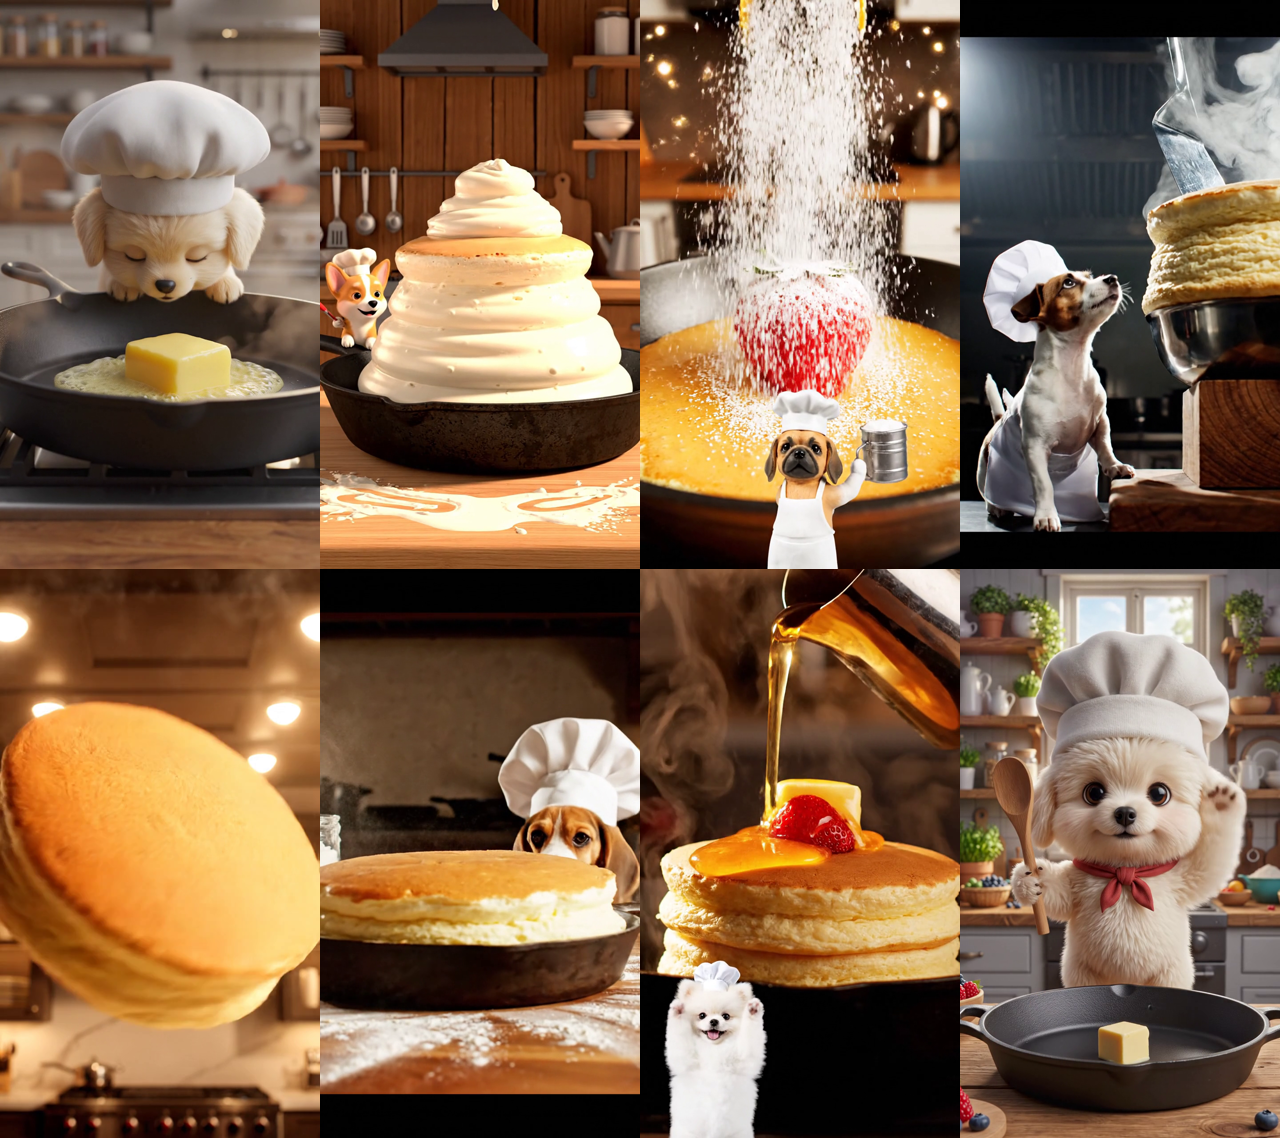
左上から順に見ると、こうなっていました。
| カット | 内容 | 出てきた犬 |
|---|---|---|
| 1 | バターを溶かす | ゴールデンレトリバーの子犬 |
| 2 | 生地を流す | コーギー |
| 3 | イチゴと粉砂糖 | パグ |
| 4 | フライ返しをセット | ジャックラッセル |
| 5 | 空中フリップ | (犬が映っていない) |
| 6 | フライパンでキャッチ | ビーグル |
| 7 | シロップをかける | ポメラニアン |
| 8 | 食べてループ | クリーム色のプードル |
パンケーキの焼き色も、木のカウンターも、朝の光の角度も繋がっています。繋がらなかったのはキャラクターだけでした。
しかも生成中は気づきませんでした。1カットずつ見ていると、どれも「白いコック帽をかぶった小さい犬のシェフ」に見えるからです。並べて初めて分かりました。
前回と変えたのは、素材の渡し方だけだった
Flowには「素材(Ingredients)」という機能があって、画像や動画をプロンプトと一緒に渡せます。
前回やったこと
Cut 01のmp4から最後のフレームをPNGで抜いて、それをCut 02の開始画像に指定する。以下、同じ手順の繰り返し。
今回やったこと
前のカットの動画そのものを素材に入れる。プロンプトの冒頭にはこう書きました。
Continuing directly from the final frame of the reference video,
same character and same kitchen.
動画を渡すほうが情報量が多くて良さそうに思えたんです。ラストフレームを抜いて保存して再アップする手間も省けます。
結果は逆でした。
動画素材が継ぐもの、継がないもの
繋がったものと繋がらなかったものを分けると、きれいに分かれます。
繋がった
- 厨房のセット(棚の位置、窓、木目)
- 朝の光の色と方向
- パンケーキの厚みと焼き色
- カメラの寄り引きのトーン
繋がらなかった
- 犬種
- 毛の色
- 顔の造作
「白いコック帽をかぶった小さい犬のシェフ」という役柄は毎回守られています。守られていないのは個体のほうです。
動画素材から読み取られているのは、どうやらシーンの雰囲気と構図までで、キャラクターの同一性はそこに含まれていないようでした。一方で前回のラストフレームPNG方式は、その1枚に写っている個体そのものを開始画像として固定します。同じ「前のカットを渡す」でも、性質が違ったのだと思います。
前回の記事と結論が逆に見える件
前回の記事では、キャラの一貫性についてこう書きました。
文章による外形指定を減らし、開始画像のデザインを優先する指示へ変更しました(中略)画像と矛盾する外見説明を追加しない
今回、直ったのは逆のことをしたときでした。文章で外見を足したのです。しかも否定形で。
The puppy chef Potofu must look exactly like the character sheet image:
a thumb-sized fluffy CREAM-WHITE poodle puppy with big round black eyes,
an oversized floppy white toque hat and a red neck scarf.
Not a brown or beagle dog.
Not a brown or beagle dog. の一行です。肯定形で「クリーム色のプードル」と書くだけでは押し切れず、出てほしくないものを名指ししたら止まりました。
矛盾しているようですが、前提が違うだけだったのだと思います。
| 前回 | 今回 | |
|---|---|---|
| 渡していた素材 | ラストフレームの画像 | 前カットの動画 |
| 外見を決めていたもの | 画像 | 何もない |
| 文章で外見を足すと | 画像とぶつかって崩れる | 唯一のよりどころになる |
画像で外見が固定されているなら、文章で外見を足すのは邪魔。固定されていないなら、文章が唯一の手綱。 同じ「文章で外見を指定する」でも、画像があるかないかで効果が反転します。
前回の私は画像を渡していたので「文章を減らせ」が正解でした。今回の私は動画しか渡していなかったので「文章で名指ししろ」が正解でした。どちらも条件つきの結論だったわけです。
今ならこうする
2つを組み合わせるのが正解だと思います。
1. キャラクター設定画像を先に1枚作る
Flowの画像生成(Nano Banana)で、正面・横・斜めの3面が入った設定画像を作ります。クレジットは消費しませんでした。
Character sheet of a thumb-sized fluffy puppy chef named Potofu,
cream-white fur, big round black eyes, wearing an oversized floppy
white toque hat and a red neck scarf, tiny white apron.
Three views: front, side, three-quarter.
Pixar-style 3D character render, soft morning light,
clean neutral background, consistent proportions.
2. 毎カット、設定画像と前カットの両方を渡す
役割が違うので、両方要ります。
- 前カット(動画かラストフレーム画像) … 構図を継ぐ。どこから始まるか
- 設定画像 … 同一性を保つ。誰が出るか
3. 文章は、設定画像と矛盾しない範囲で名指しする
設定画像と同じ外見を書くぶんには衝突しません。衝突するのは、画像と違うことを書いたときです。
人物の一貫性そのものを掘った記録は「Flow Musicで人物が崩れない30秒MVができるまで7回」に書きました。参照画像の選び方で結果がどう変わるかを比較しています。
逆に、Geminiで8カット作ったときは「キャラを揃えるより『終わり方』が難しかった」という結論でした。ツールが違うと詰まる場所も違う、というのがこの3本を並べたときの実感です。
ついでに分かったFlowの実務的なこと
「続きを生成」はモデルを選べない
タイムラインのクリップ末尾にある「続きを生成」は、前のカットから自動で繋いでくれます。ただしVeo 3.1 Lite に固定で、モデルを選べません。
Liteは描写が変わるので、他のカットをFastで作っていると、そこだけ絵柄が浮きます。カット間の絵柄を揃えたいなら使わないのが無難でした。
生成の単価(9:16・8秒・1件あたり)
2026年9月時点で、実際に画面に表示された値です。
| モデル | クレジット |
|---|---|
| Veo 3.1 – Quality | 100 |
| Veo 3.1 – Fast | 20 |
| Omni 1.1 Flash | 12 |
| Nano Banana 2(画像) | 0 |
8カットならFastで160、Qualityだと800。まずFastで通しを完成させて、気に入ったカットだけQualityで撮り直すのが無駄がないと思います。
なお、リロードやエラーのたびにモデル選択が勝手に下位へ戻ります。送信前に毎回見たほうがいいです。
理由を言わずに弾かれることがある
「失敗 申し訳ございませんが、この動画を生成できませんでした。この生成に対する請求は発生しません」とだけ出て終わります。課金はされませんが、理由は教えてくれません。
今回はパンケーキが落下するカットで出ました。言い換えたら通りました。
| 弾かれた語 | 通った語 |
|---|---|
| plummets(急降下する) | floats back down |
| heroic effort | all his strength |
| straining grunts(うめき声) | tiny effortful squeaks |
| hip-attack | hip-drop |
映像は変わりません。「うめき声」を「小さな鳴き声」に変えても、出てくる絵と音はほぼ同じでした。変わるのは打つ言葉だけです。
大事なのは推測で全部書き換えないこと。怪しい語を1つずつ外して二分探索しないと、次のカットでまた踏みます。Geminiでも同じ現象があって、切り分け方は「Geminiで動画が生成されない原因は「単語」だった」に書きました。4分待たされてエラーすら出ないパターンです。
書き出しは数分かかって、しかもzipで届く
「シーンをダウンロード」を押しても、すぐには来ません。数分後にダウンロードフォルダへ届きます。押した直後にフォルダを見て「落ちてこない」と判断すると、もう一度押すことになります(やりました)。
さらに、届くのは1本のmp4ではなく、クリップが個別に入ったzipです。中のファイル名がこうなっています。
<root>_<context>_</context>_<instruction>_<prompt>Continuing_20260923172805_3.mp4プロンプトの冒頭が機械的に切り出されているだけで、末尾の連番はタイムラインの順番と一致しません。今回は8本中7本が Continuing で始まっていて、名前から順番が判別できませんでした。
並べ直すには、各クリップの先頭フレームを抜いて横に並べるのが早いです。1枚の画像にしてしまえば一目で分かります。
チェックリスト
- 先にキャラクター設定画像を1枚作る(クレジット消費なし)
- 毎カット、設定画像と前カットの両方を素材に入れる
- 文章の外見指定は、設定画像と矛盾しない範囲で書く
- 「続きを生成」は使わない(Veo 3.1 Lite固定)
- 縦型で出すなら最初から9:16で撮る
- まずFastで通しを完成させる
- 送信前にモデル名を毎回確認する
- 弾かれたら二分探索。推測で一括書き換えしない
- 書き出しは数分待つ。zipで届く前提でいる
- 繋ぐ前に、各カットの1フレームを並べて確認する
最後の1行が今回の反省です。1カットずつ見ていたら気づきませんでした。
おわりに
同じツールで同じ尺のものを2回作って、1回目と2回目で詰まった場所が違いました。1回目は「繋ぎ方」、2回目は「誰が出るか」。
AI動画は作り直しても同じものが出てこないので、揃えたいものは必ず名指しするしかないのだと思います。名指しの仕方が画像なのか文章なのか、その場の条件で変わるだけでした。
他のAI動画の制作記録は「Geminiで80秒のショートアニメを作ったら、敵は「Chromeのタブ」だった話」にもまとめています。